方案多看一遍,边界少漏一点。
同一段代码,同一份方案。对照根因、边界和风险,再验证建议。
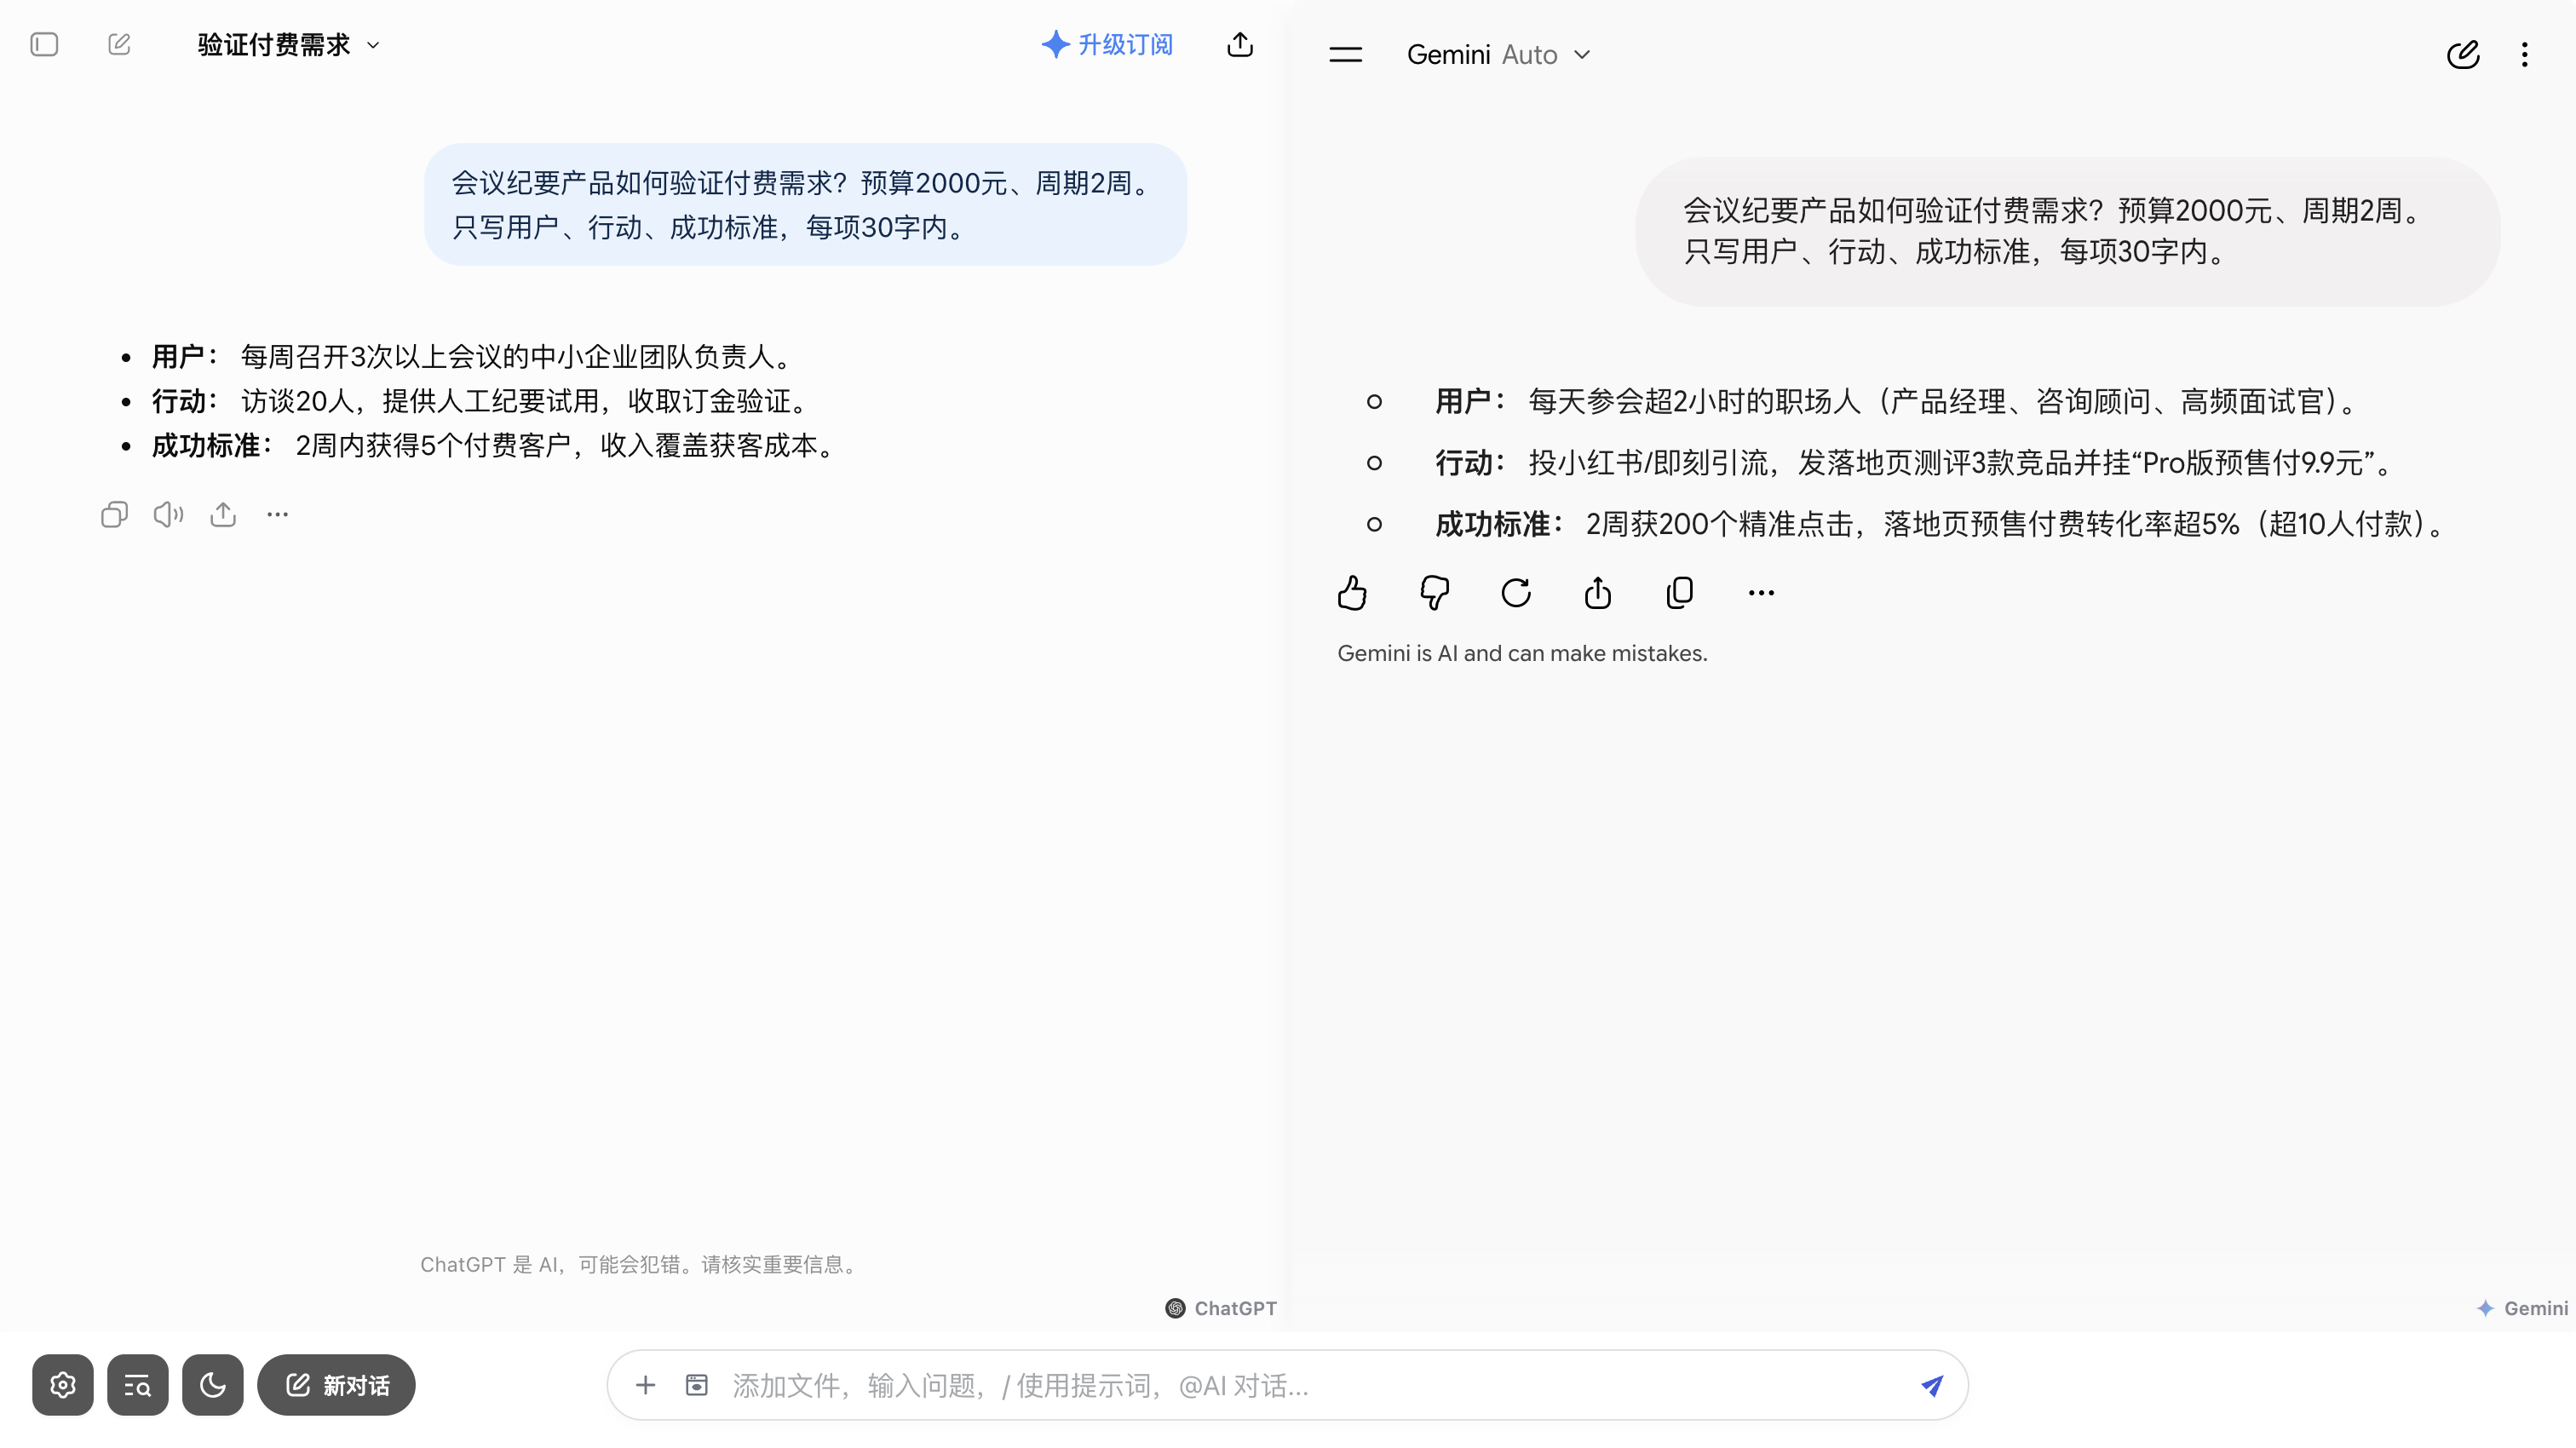
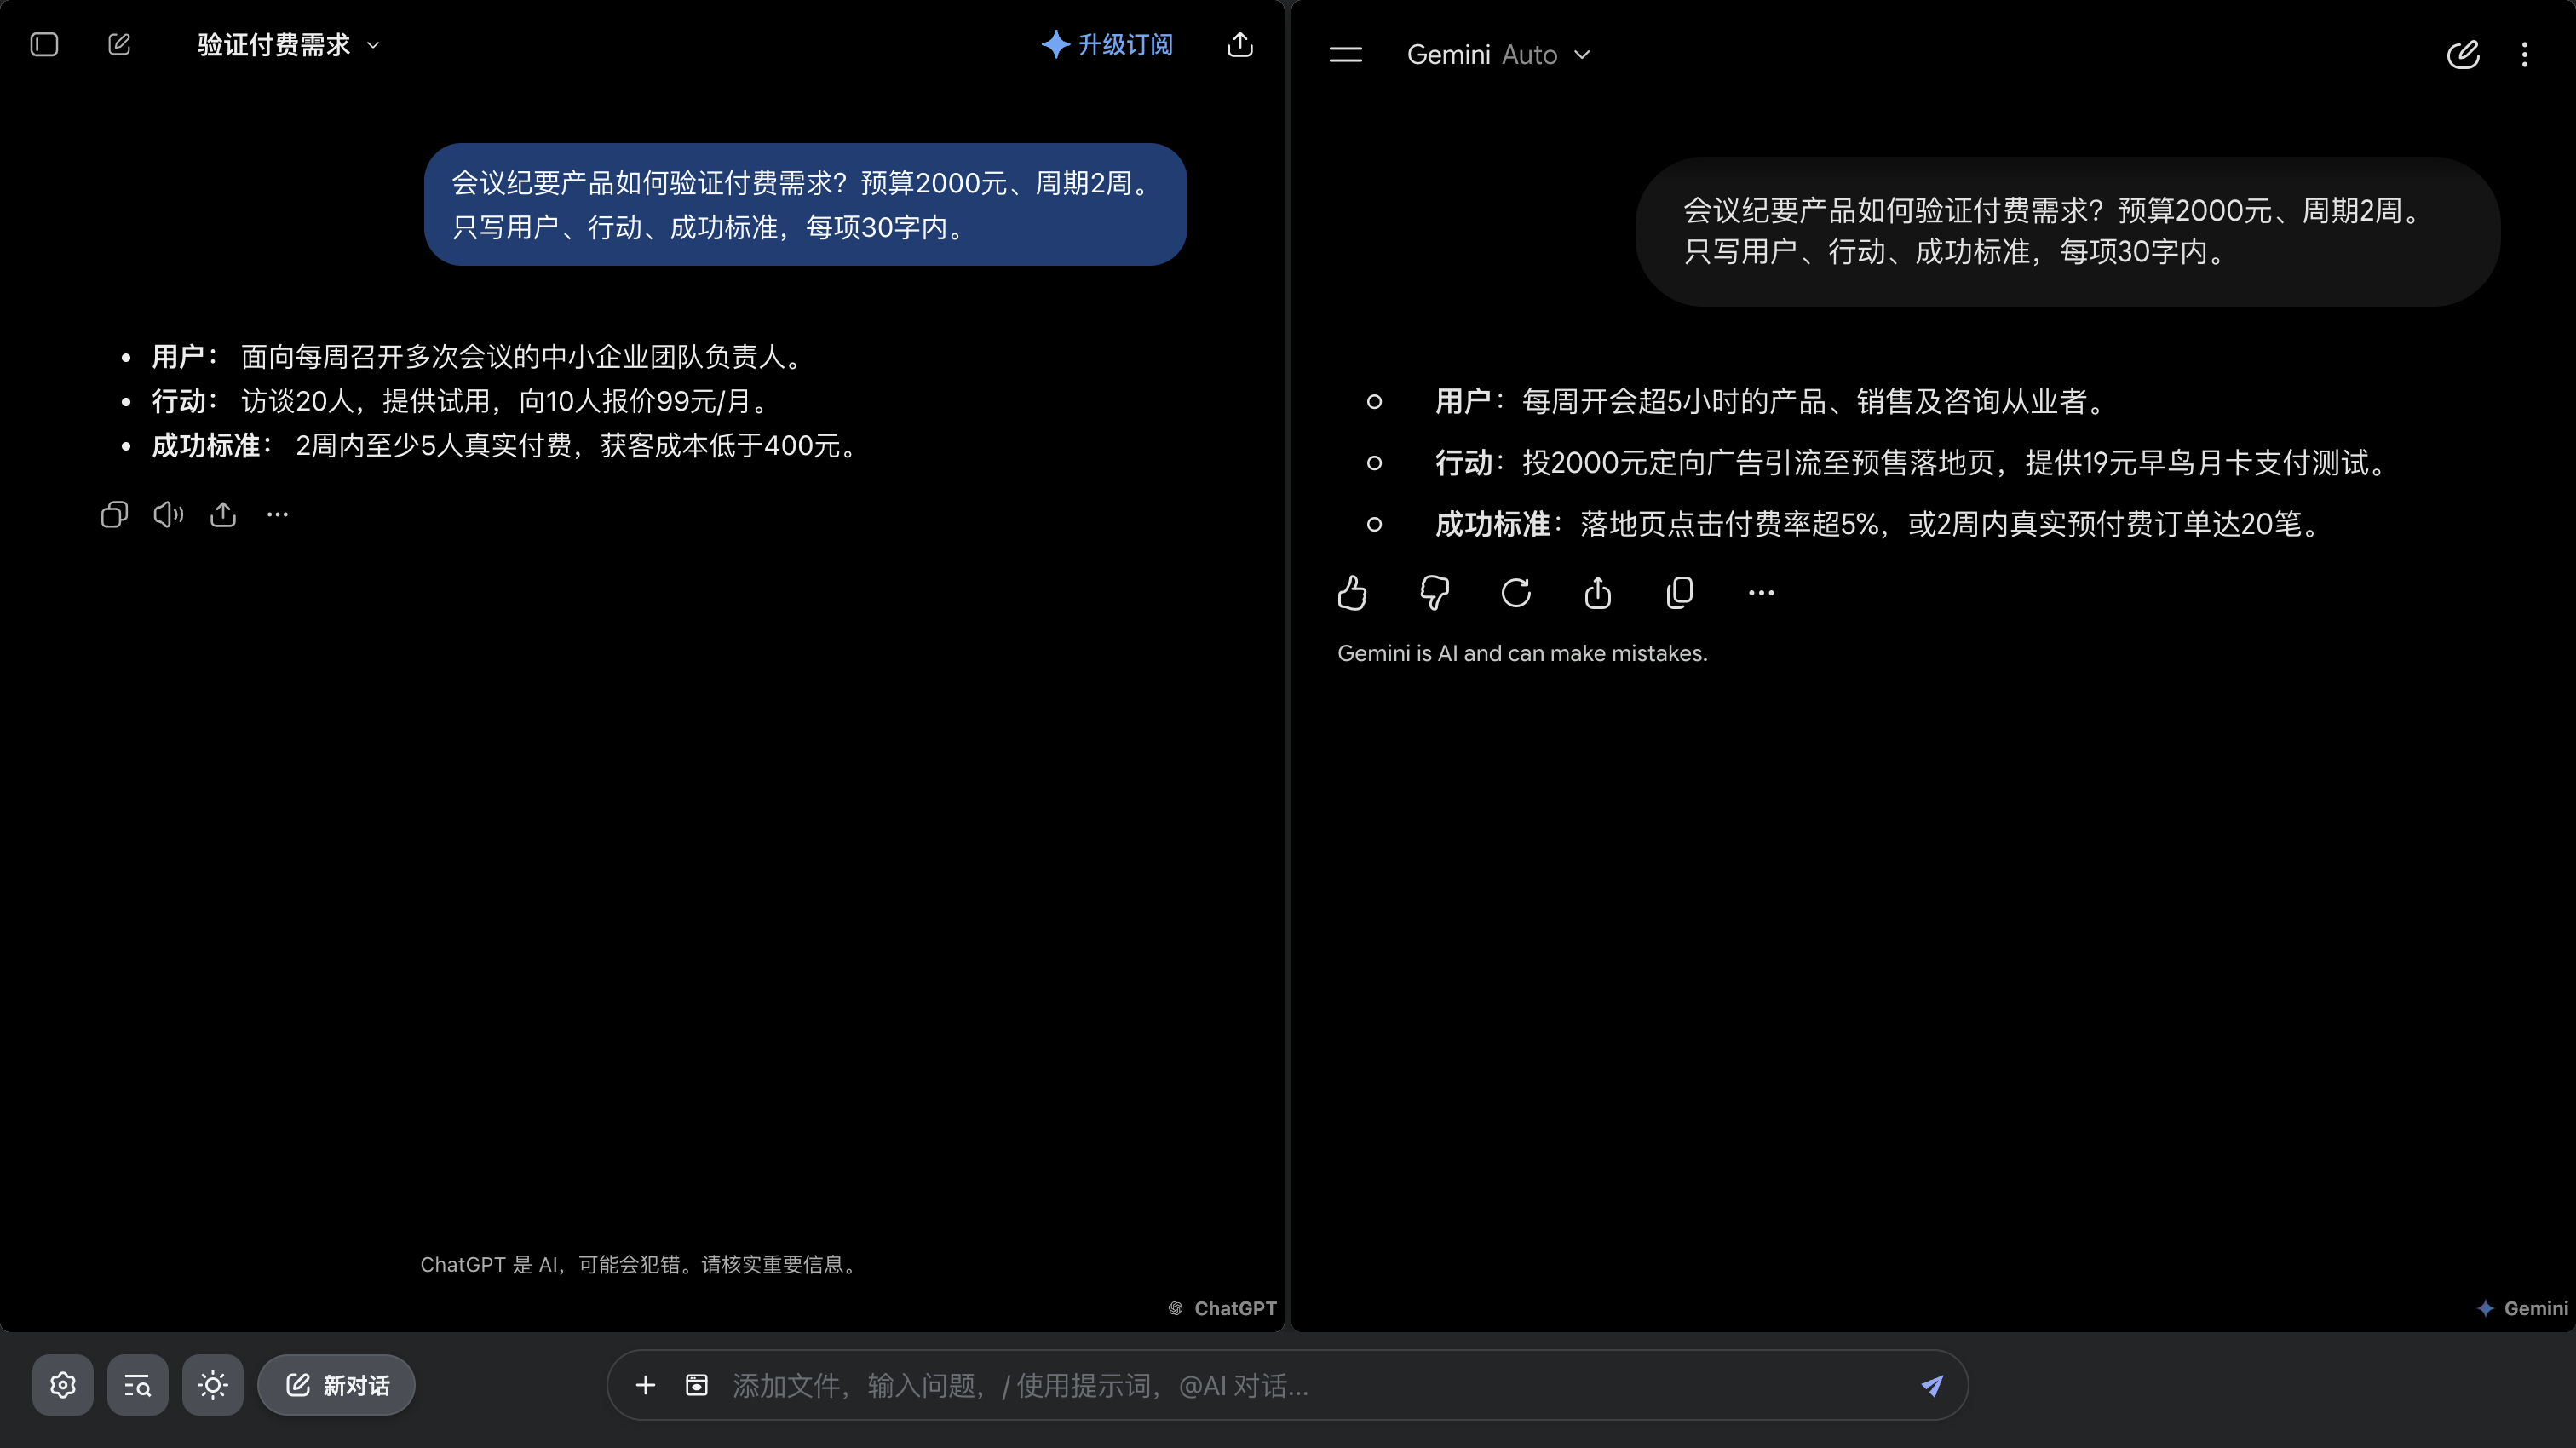
选择参与比较的 AI
可选择 ChatGPT、Claude、DeepSeek 等常用 AI,数量与组合由你决定。给各家相同的代码、报错和约束,再比较依据。
先找多家都指出的根因,再验证只有一家提出的建议。表达流畅不能替代测试和证据。
对比流程
- 把报错、相关代码与目标行为写进同一问题,并要求输出残余风险
- 把同一问题发给所选 AI
- 标出多家一致的根因,以及只有一家提出、仍需验证的建议
- 用 @ 选择依据最完整的一列,补测试、失败路径与最小改动
- 需要时把最终补丁再发给另一模型做二次审查
重点看这里
- 是否理解真正失败条件,而不是只修表面报错
- 是否引入隐藏副作用(并发、缓存、空值、权限)
- 是否给出可验证步骤:测试、日志、回滚
- 是否可在你当前代码结构中落地,最长答案往往不是最优
对比提问模板
- 背景:语言/框架、模块职责
- 现象:完整报错栈或错误输出
- 期望:正确行为
- 已尝试:排除过的方向
- 约束:不能大改架构 / 向后兼容 / 性能
- 输出:根因假设、最小补丁、测试步骤、残余风险
一个 AI 就够用的时候
- 可以快速检查的样板代码或简单增删改查草稿
- 依赖某站独有 IDE 集成的工作流
常见问题
一定要三个模型都开吗?
不必。可以自行选择 AI 数量与组合。对比时保持代码、问题和约束一致,建议是否可靠仍要靠测试与证据判断。
和直接开多个浏览器标签有什么区别?
同一问题发送给所选 AI,再用 @ 追问,减少复制粘贴和窗口切换。
会不会泄露代码到 ChatBrawl 服务器?
不会。内容通过浏览器交给你选择的 AI 官网;请遵守各平台条款与公司合规要求。
相关阅读
用同一个问题检查方案
安装插件,把代码与约束一次发给多家 AI,再核对根因、边界和测试路径。